الترويج عبر الذكاء الاصطناعي: كيف وصل الموقع إلى إجابات ChatGPT
يُطرح الترويج في أدوات الذكاء الاصطناعي، وهو تحسين GEO ذاته، اليوم كخدمة بضمانات: «+120 % من الزيارات من البحث بالذكاء الاصطناعي»، «ضمانات في العقد»، من 29 ألف روبل شهريًا. نحن لا نقدّم ضمانات، لكن لدينا ملاحظة: في أكتوبر 2026 وصل إلى الموقع طلبان يحملان وسم utm_source=chatgpt.com. طلبان لا يثبتان شيئًا، ولن تجد هنا استنتاجات عن «كيف تظهر في ChatGPT». بل ستجد الآلية التي وصل بها الوسم إلينا، وقائمة بما كان قائمًا على الموقع قبل ذلك، وقائمة بما لا نعرفه. والفائدة العملية منها واحدة: كيف تضبط التتبع بحيث تظهر الطلبات القادمة من أدوات الذكاء الاصطناعي.
الإجابة المختصرة
يمكن أن يظهر الموقع في إجابات ChatGPT دون عمل منفصل مخصص لأدوات الذكاء الاصطناعي: في أكتوبر 2026 وصل إلى meermost.site طلبان يحملان وسم ChatGPT، أحدهما عبر الحاسبة، والثاني عبر النموذج الذي اتصل صاحبه بنفسه هاتفيًا بعد إرساله. لا نعرف ما الاستعلام الذي كُتب، ولا يمكن الحكم على الطريقة من طلبين. وما يمكنك فعله في موقعك: أن تكون داخل الفهرس، وأن تجيب عن الأسئلة مباشرة، وألا تخفي الحقائق خلف الصياغات، وأن تحتسب الزيارات بحيث تظهر الزيارات القادمة من الذكاء الاصطناعي.
كيف رأينا الزيارات القادمة من ChatGPT: الوسم واللمسة الأولى
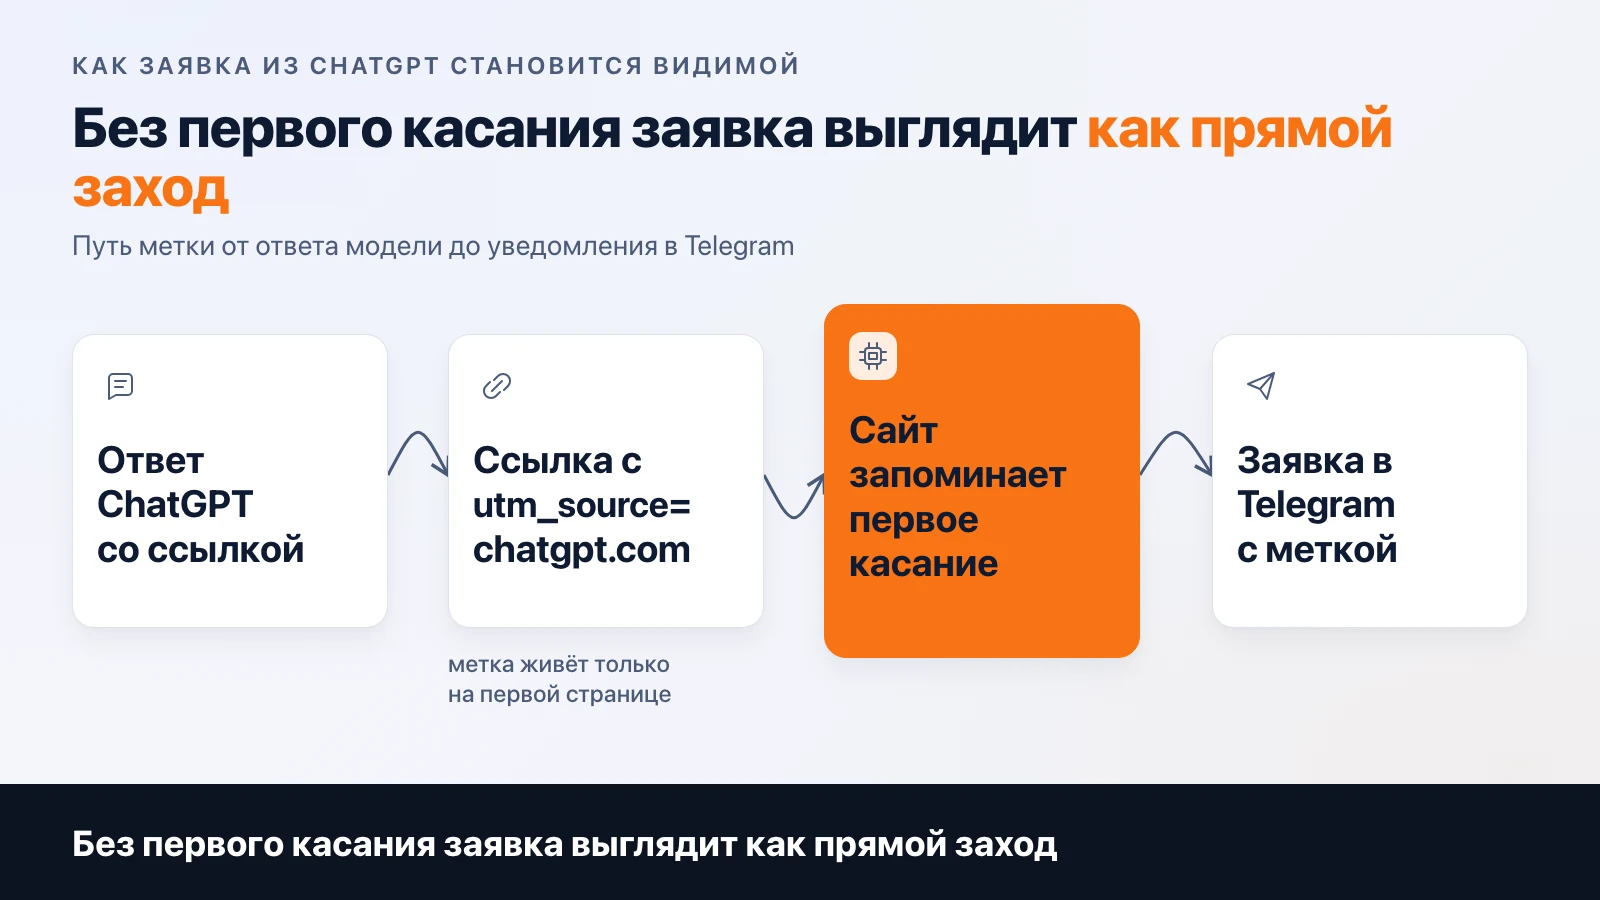
يضيف ChatGPT إلى الروابط في إجاباته وسم utm_source=chatgpt.com. ينقر الشخص فيصل إلى الموقع والوسم موجود في العنوان، ثم يتنقل بين الصفحات دونه. وإذا لم تفعل شيئًا، يضيع الوسم عند أول انتقال، ويبدو الطلب القادم من الصفحة الثالثة كزيارة مباشرة.
في موقعنا تُحفظ اللمسة الأولى: يُسجَّل الوسم من العنوان في جلسة المتصفح عند أول زيارة ولا يُستبدل. وعند إرسال طلب أو إجراء حساب في الحاسبة، ينتقل الوسم معه إلى الإشعار في Telegram. مثال: هكذا يبدو هذا الإشعار، ولا توجد فيه حقول زائدة:
[meermost.site]
Расчёт калькулятора приложения
• Платформа: iOS + Android
• Функции: Сложные
• Дизайн: Кастомный
• Бэкенд: Не нужен
• Сроки: 1–2 месяца
Вилка: 1 250 000 ₽ – 1 760 000 ₽
utm: source=chatgpt.com
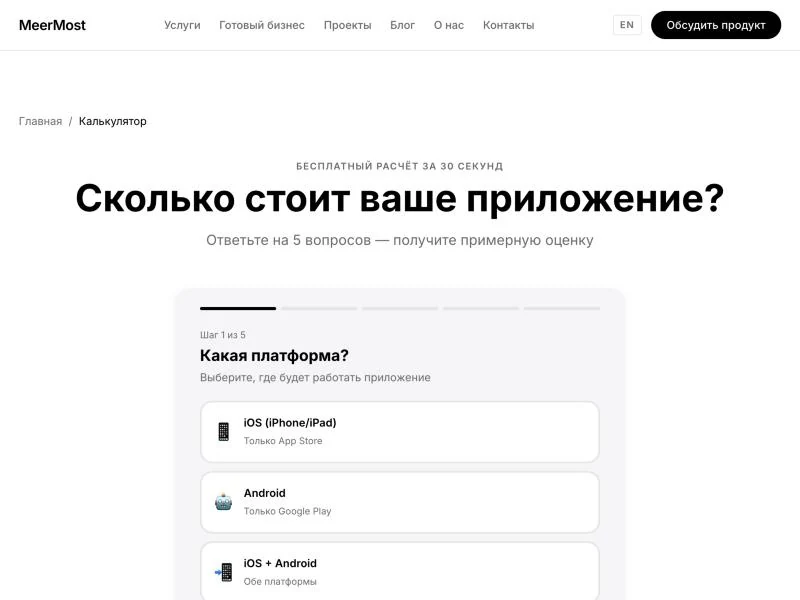
حاسبة من خمسة أسئلة. يصل الحساب إلى محادثتنا دون بيانات هوية، ومعه وسم اللمسة الأولى إن وُجد.
وصل الطلب الثاني في 21 أكتوبر عبر نموذج التواصل بالوسم نفسه. كتب الشخص وصفًا للمشروع في سطر واحد، وبعد دقائق اتصل بنفسه. لا أذكر الاسم ولا موضوع المشروع هنا.
ملاحظتان حتى لا يبدو الأمر أكثر ترتيبًا مما هو عليه. الأولى: كتب أحد التحليلات الغربية أن ChatGPT توقف منذ 9 أكتوبر 2026 عن وضع هذا الوسم على الروابط؛ لكن الوسم كان موجودًا لدينا في 13 و21 أكتوبر. إما أن الأمر لم يشمل الجميع، أو لم يشمل كل الإجابات. الثانية: بحسب بيانات المحللين أنفسهم، لا يمرّر تطبيق ChatGPT للهواتف بيانات المُحيل (referrer)، لذا لا يمكن تمييز الزيارات القادمة منه بلا وسم عن الزيارات المباشرة. وكم كان منها، لا نعرف.
ما كان على الموقع قبل هذين الطلبين
قائمة بما كان قائمًا على الموقع حتى أكتوبر، دون تقييم لما نجح منه. ولا يصح اعتبارها خطة «كيف تظهر في ChatGPT»: فكل البنود ظهرت من أجل البحث العادي والقارئ الحقيقي.
- ملف
llms.txtعلى العنوان meermost.site/llms.txt: الخدمات والأعمال الجاهزة والمقالات في نص واحد مع الروابط. يُجمَّع من الترجمات نفسها التي تُبنى منها الصفحات، لذا لا يختلف عنها. - ملف robots.txt بإذن صريح لـ 19 روبوتًا بالاسم: GPTBot وOAI-SearchBot وChatGPT-User وClaudeBot وPerplexityBot وغيرها. قاعدة
User-agent: *تسمح لها أصلًا، لكن بعض المشغّلين يفسّرون غياب اسمهم كرفض غير مباشر. - قسم أسئلة وأجوبة في صفحة الأعمال الجاهزة وفي المقالات، بترميز FAQPage.
- إجابة مباشرة بعد العنوان الفرعي الرئيسي في المقالات، قبل الاستطراد. هذه قاعدة من خط إنتاج مقالات SEO لدينا، وهي تعمل بالطريقة نفسها مع مقتطف البحث ومع الاقتباس في إجابة الذكاء الاصطناعي.
- الأسعار في صفحات الخدمات وحاسبات بنطاق سعري، لا «اترك طلبًا وسنحسب لك».
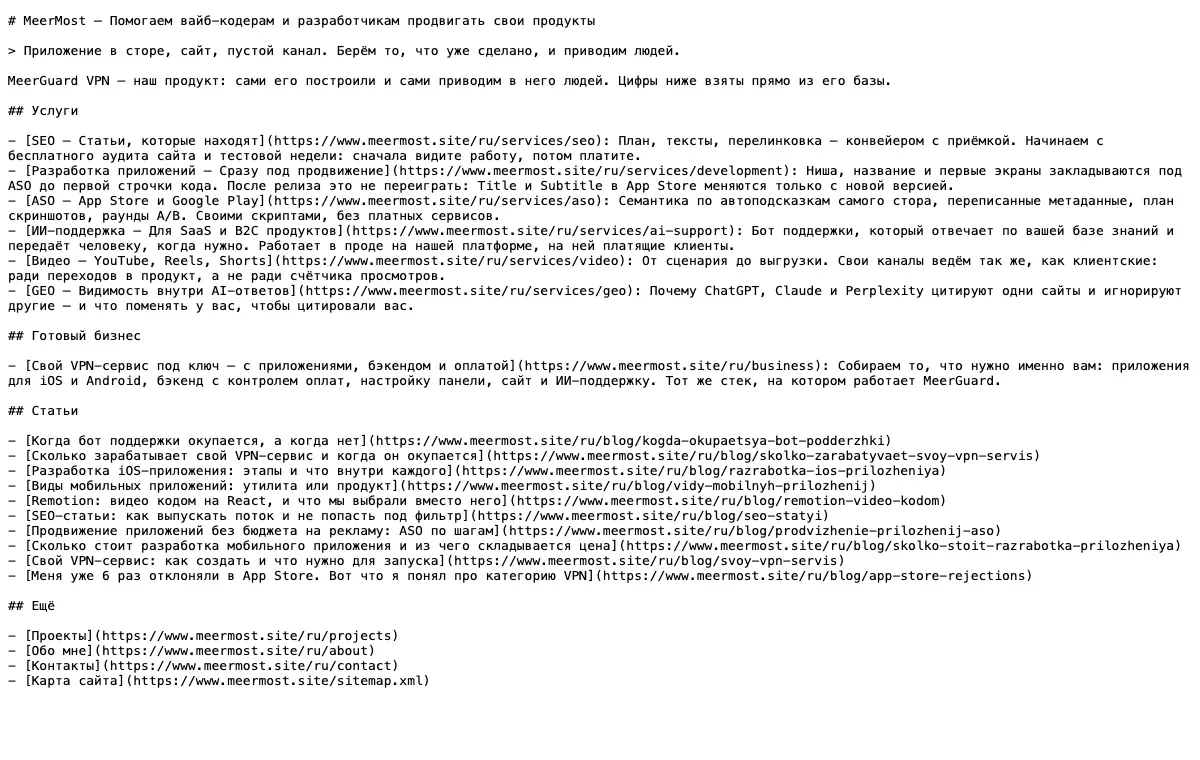
ملف llms.txt يتسع كاملًا في شاشة واحدة. إنه ليس معيارًا ولا التزامًا، بل أرخص طريقة لتكون مفهومًا للمساعد: صفحة كود واحدة وصفر صيانة.
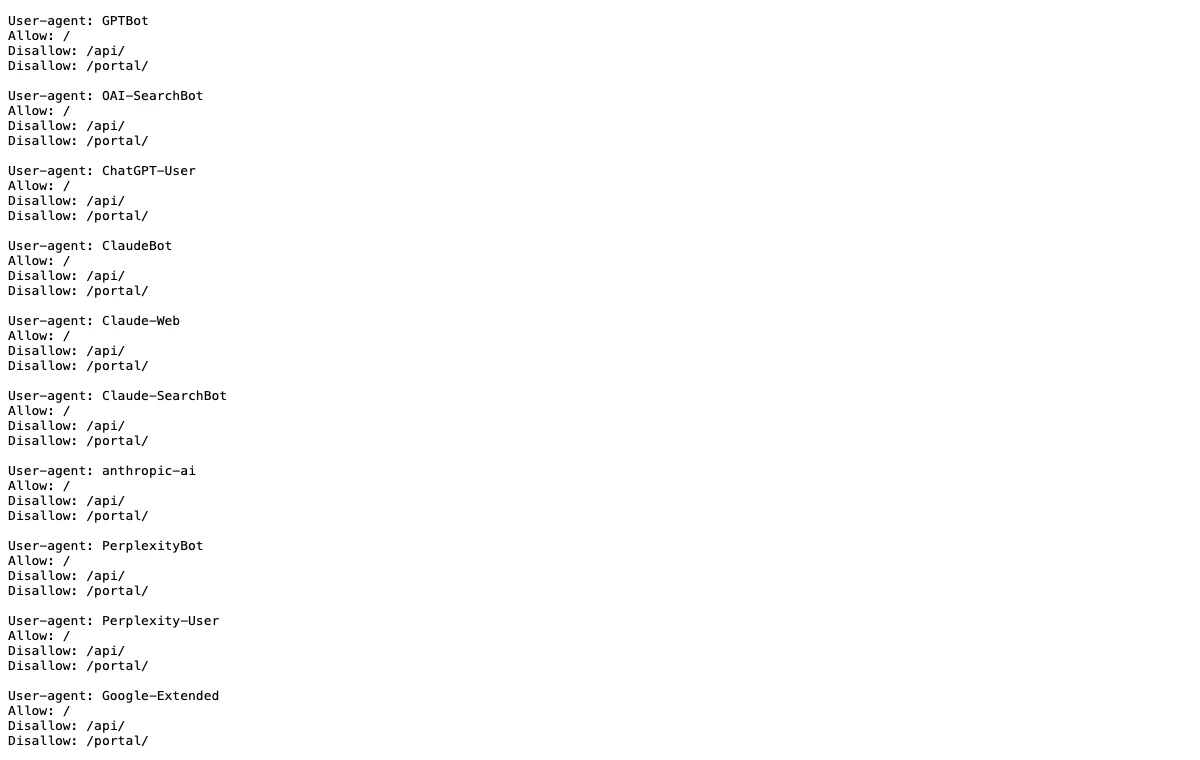
ملف robots.txt للموقع: كل روبوت مذكور بالاسم، رغم أن القاعدة العامة تسمح لها أصلًا.
لا يوجد في هذه القائمة بند واحد أُثبت أنه السبب. وصل الطلب الأول عبر حاسبة تكلفة التطبيق، ومن المنطقي أن نفترض أن ChatGPT كان يجيب عن سؤال مثل «كم تكلفة تطوير تطبيق»، حيث يوجد على الموقع مقال بأسعار معلنة. لكنه افتراض، لا بيانات.
ما هو GEO وكيف يختلف عن SEO
GEO (generative engine optimization، أي تحسين الظهور في المحركات التوليدية) هو العمل على أن يذكر النموذج منتجك في إجابته. يختلف عن SEO في النتيجة، أما الأساليب فهي نفسها: في البحث تحصل على مرتبة داخل قائمة من عشرة، وفي إجابة النموذج على ذكر داخل قائمة من عنصرين أو ثلاثة، أو لا شيء. لا يوجد حل وسط.
مع ذلك، الأساس واحد. في وضع البحث يأخذ ChatGPT صفحات من فهرس الويب، والموقع غير الموجود هناك لن يظهر في الإجابة. لذلك فإن «الترويج في الذكاء الاصطناعي بدون SEO» أشبه ببيع طابق ثانٍ بلا طابق أول. وما يُضاف فوق ذلك: إجابات مباشرة عن الأسئلة بنص يمكن اقتباسه دون فقدان المعنى، وحقائق وأرقام بدلًا من «موثوق وعالي الجودة»، وإشارات في منصات خارجية تأخذ منها النماذج بياناتها.
كيف تتحقق مما إذا كانت نماذج الذكاء الاصطناعي تذكرك
لا توجد لدينا أداة خاصة للقياس، نقيس يدويًا، وهذا مكتوب في صفحة الخدمة. والترتيب كالتالي:
- دوّن 10–15 سؤالًا يطرحها عميلك: «كم سعر X»، «أي X أختار من أجل Y»، «أفضل X في 2026».
- اطرح كل سؤال في ChatGPT وPerplexity وAlice، في وضع البحث. وسجّل من ذُكر.
- أعد ذلك بعد أسبوع: الإجابات متقلبة، وجولة واحدة لا تكفي.
- افتح المواقع المذكورة وقارنها بموقعك: هل لديها إجابة مباشرة عن هذا السؤال، وسعر، وجدول، وأسئلة شائعة.
- تحقق من أن موقعك مُفهرس أصلًا في Bing وGoogle على هذه الاستعلامات.
النقطة الخامسة تستبعد نصف حالات «لا يذكروننا»: الموقع ببساطة غير موجود في نتائج البحث، والسبب ليس في نماذج الذكاء الاصطناعي.
كيف تحسب حركة المرور القادمة من الذكاء الاصطناعي لديك
لرؤية الطلبات القادمة من ChatGPT تحتاج إلى ثلاثة أشياء، ولا واحد منها يتعلق بنماذج الذكاء الاصطناعي.
حفظ أول لمسة. لا يوجد الوسم إلا في عنوان الصفحة الأولى؛ وإذا لم يحفظه الموقع، فسيصل الطلب بعد ثلاث انتقالات بلا مصدر. عندنا يُسجَّل هذا في جلسة المتصفح ولا يُستبدل.
تمرير المصدر إلى الطلب. إلى إشعار العميل المحتمل، وإلى CRM، وإلى أي مكان سيُطلع عليه لاحقًا. ستعرض Metrica وGA4 الزيارات، لكنها لن تخبرك أيّها تحوّل إلى طلب.
إنشاء مصدر منفصل في أداة التحليلات. في GA4 وMetrica يمكن تخصيص المُحيلات chatgpt.com وperplexity.ai وما شابهها لقناة خاصة، وإلا فستذوب في «الانتقالات عبر الروابط».
ما لا يمكن الوعد به
جدول لما نعرفه وما لا نعرفه عن هذين الطلبين. هذا أصدق من أي دراسة حالة بنسب مئوية.
| ما نعرفه | ما لا نعرفه |
|---|---|
| تاريخ ووسم كلا الطلبين | ما الاستعلام الذي طرحه الشخص على ChatGPT |
| الصفحة التي جاء منها كل طلب | الصفحة التي اقتبسها ChatGPT |
| ما كان على الموقع في تلك اللحظة | أيٌّ من ذلك أثّر |
| أن الوسم كان يُضاف عندنا في أكتوبر | كم زيارة وصلت بلا وسم، من التطبيق |
| أن كلا الطلبين عن التطوير، لا عن VPN | هل سيصبحان عملاء |
لذلك كُتب في صفحة الخدمة «السعر عند الطلب» و«لا توجد لدينا أداة خاصة بعد». الوكالة التي تَعِد بنسبة نمو في العقد تَعِد بما لا تتحكم فيه. أما ما تتحكم فيه: التعديلات على الموقع، وصفحات الحقائق، والحضور على المنصات، والقياس المتكرر. هذا هو العمل نفسه، ويمكن تقييمه. أما النتيجة في إجابات النموذج فلا.
فحص الظهور في عدة نماذج لدينا مجاني: نختبر منتجك والمنافسين على استعلامات نموذجية، ونوضح من يُذكر بدلًا منك ولماذا. بعد ذلك تأتي التعديلات على الموقع وفق القائمة أعلاه، ثم القياس المتكرر. بلا نسب مئوية في العقد.
الأسئلة الشائعة
هل يمكن ضمان الظهور في إجابات ChatGPT؟
لا. تُولَّد الإجابة من جديد لكل استعلام، وقد تختلف من شخص إلى آخر. ولا يمكن التحقق من وعد مثل «+120 % من الزيارات القادمة من البحث بالذكاء الاصطناعي» لا قبل ذلك ولا بعده.
كيف نعرف أن الزائر وصل من ChatGPT؟
من خلال الوسم utm_source=chatgpt.com في عنوان الصفحة أو من خلال المُحيل chatgpt.com. وبحسب بيانات المحللين، لا يمرر تطبيق ChatGPT على الهاتف المحمول المُحيل، لذا تظهر هذه الزيارات في أدوات القياس كزيارات مباشرة.
ما هو llms.txt وهل هو إلزامي؟
ملف نصي يحوي خريطة الموقع لوكلاء الذكاء الاصطناعي: الخدمات والمقالات والروابط في قائمة واحدة. لا يوجد معيار ولا إلزام به، ولا يلزم أي بوت بقراءته. لدينا هذا الملف، لكن لا وسيلة لقياس ما حققه بالضبط.
من أين يأخذ ChatGPT المواقع للإجابة؟
في وضع البحث، من فهرس الويب. ويُذكر عادةً أن Bing هو الشريك الأساسي، لكن OpenAI لا تنشر آلية ذلك علنًا. لذلك يبقى SEO التقليدي هو الأساس: والموقع غير الموجود في الفهرس لن يدخل في الإجابة.
ما الذي نجح مما تم على الموقع؟
لا نعرف. فالوسم لا يحمل الاستعلام الذي كتبه الشخص في ChatGPT، والطلبان ليسا عينة. يمكن تعداد ما كان على الموقع حتى تلك اللحظة، وهذا كل شيء.
مقالات ذات صلة
مقالات SEO: كيف نبني تدفقًا منتظمًا دون الوقوع في الفلتر
كيف يعمل تدفق مقالات SEO: من أين نأتي بالمواضيع، وكيف نختار العناقيد الكلماتية، ولماذا سقف 8–12 مقالًا شهريًا، ولماذا يقرأ إنسان كل مقال قبل نشره.
صانع الأحذية ارتدى حذاءه: كيف صنعت موقع بورتفوليو بعد 3 سنوات من العمل للعملاء
ثلاث سنوات وأنا أصنع مواقع وتطبيقات للعملاء، بينما لم يكن لدي موقع خاص بي. تفكيك بنية meermost.site: Next.js 15، وتعدد اللغات i18n، ومدونة على markdown، وآلات حاسبة كصفحات SEO.
خادم خدمة VPN: أي VPS تختار وكم يتحمّل
ما VPS الذي تحتاجه خدمة VPN قائمة على الاشتراكات: النطاق الترددي وحدّ حركة البيانات والمعالج. أرقام من خدمة قائمة فعليًا: 79 تيبي بايت شهريًا، و395 مستخدمًا متصلًا، وما الذي يبلغ حدّه أولًا.